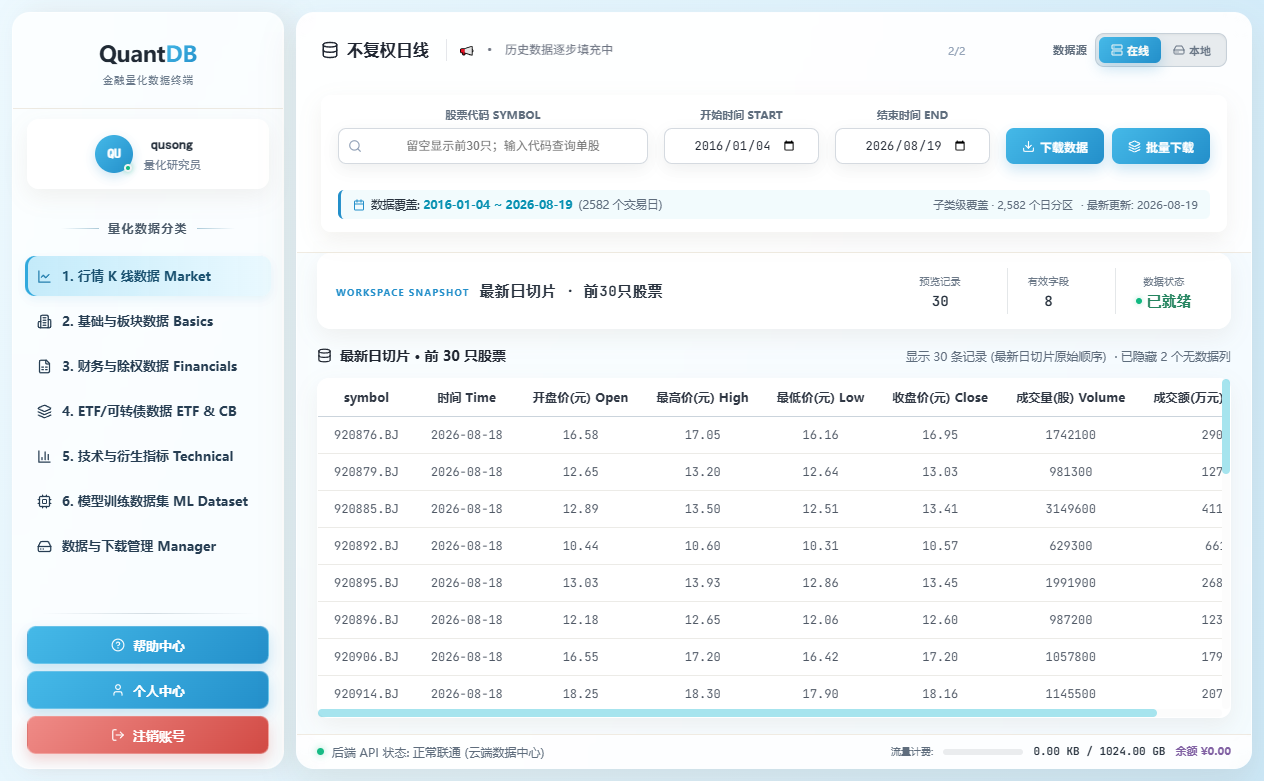
告别传统 API 的高延迟与频发限流。全量数据存于对象存储、经 CDN 高速分发,下载不限速、不限频。 K 线 / Tick / 财务 / 因子切片秒级落盘本地,结合 Python SDK 内置的 DuckDB 本地数据仓库引擎, 实现“下载即数据库,本地零流量毫秒级回测”。
为 AI / 机器学习量化团队量身定制,解决数据获取慢、手工算因子累、API 限流频发等核心痛点。
按 (symbol, date) 严格对齐,融合量价动量、波动率及严格公告日财务三表 (PiT),开箱直喂 LightGBM / XGBoost / PyTorch。
全量数据经 CDN 边缘多线程并发加速,下载不限速、不限频。全 A 股十年日线约 3 分钟拉齐,盘后仅需增量补丁秒级同步。
无需繁琐的服务端配置,直接对本地 Parquet 进行极速向量化查询与毫秒级跨表 JOIN,回测运算零网络流量延迟。
兼顾 Python 脚本/Jupyter 代码自动化调用,与桌面 GUI 的可视化数据预览、离线下载管理与批量导出。
仅需几行代码,即可将全市场标准化数据与因子矩阵直接注入回测与研究流程。
from quantdb import Client # 初始化客户端 (支持环境变量 QUANTDB_TOKEN 自动认证) client = Client(token="YOUR_API_TOKEN") # 一键获取 300+ 维预计算因子宽表 (自动按 (symbol, trade_date) 对齐) df = client.get_factor_matrix( symbols=["600519.SH", "300750.SZ", "688981.SH"], start_date="2023-01-03", end_date="2025-12-31" ) # 直接喂给 LightGBM / XGBoost / PyTorch 进行模型训练 print(f"数据维度: {df.shape} | 因子列数: {len(df.columns)}") print(df[["close", "mom_ret_20d", "vol_atr_14", "style_ep"]].head())
import duckdb # 本地零网络流量,直接对 Parquet 目录进行高性能向量化 SQL 分析 con = duckdb.connect() query = """ SELECT symbol, trade_date, close, mom_ret_20d, style_ep FROM 'data/factors/*.parquet' WHERE trade_date >= '2026-01-01' AND mom_ret_20d > 0.15 ORDER BY mom_ret_20d DESC LIMIT 10; """ result_df = con.sql(query).df() print(result_df)
告别传统 API 的漫长等待、频繁限流与手工清洗。为现代 AI 量化投研重新定义数据吞吐底座。
单次请求行数受限,频繁触发风控限流,研究员需耗费大量时间处理数据清洗与基础设施运维。
对象存储高速分发,300+ 维预计算因子宽表直接提供,集成 DuckDB 本地零流量秒级回测。
扫描下方二维码快速加入官方群,领取《300+ 维量化因子字典与实战手册》,与量化宽客共同交流模型与策略。